日常营养干预是一个离医疗很近的赛道。近,意味着用户价值高;也意味着每一步都可能踩线。过去几年,行业里因为一句宣传语、一个检测推荐、一次数据共享而被迫停摆的案例并不少见。
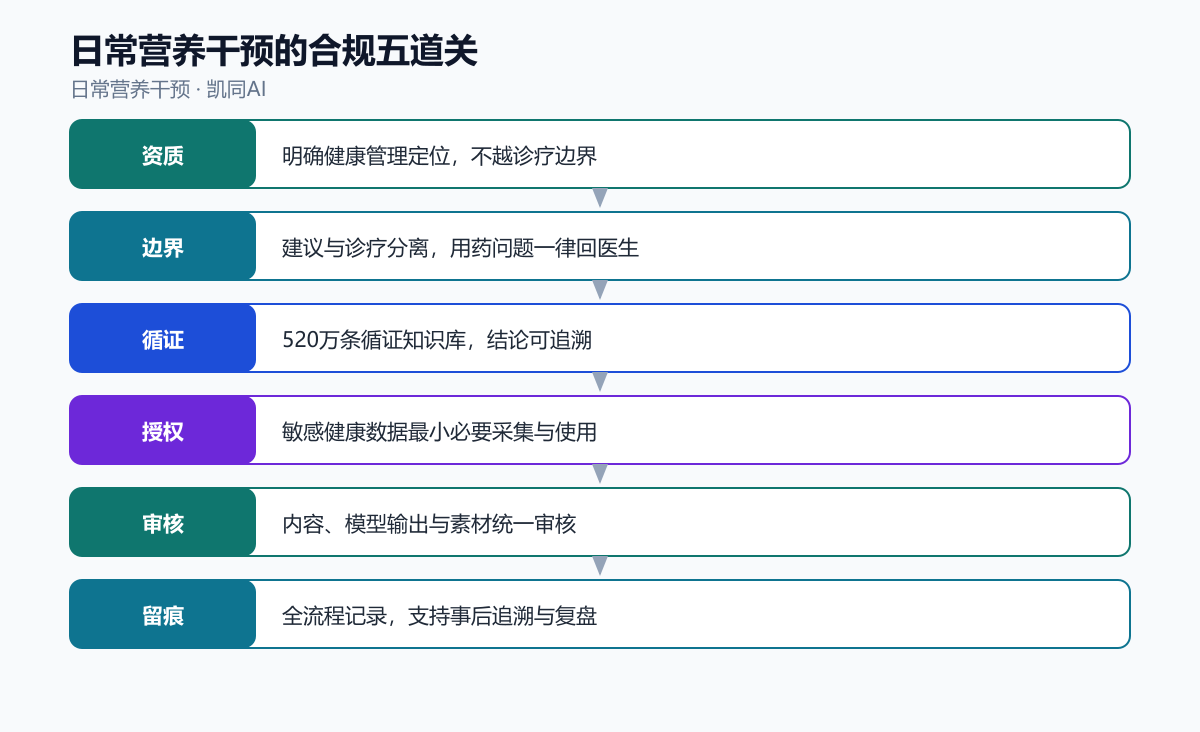
一、四条红线
- 不能诊断:任何可能被理解为疾病判断的输出,都必须改写或移除。
- 不能替代诊疗:方案是健康管理建议,不是治疗方案。
- 不能调整用药:涉及处方的问题,唯一正确动作是引导回医生。
- 不能滥用数据:敏感健康数据的采集、使用与共享都要有明确授权。
这四条看起来是常识,但在产品迭代中极易被突破——因为“更有用”和“更安全”经常方向相反。
合规风险往往不是来自恶意,而是来自“顺手”:产品经理为了让建议更有用,多加了一句判断,就越过了边界。
二、健康建议与医疗行为的边界
营养建议不能宣称治疗疾病,慢病人群与孕产人群的方案需要更严格的边界与转诊机制。
边界不是靠话术绕开的,而是靠产品结构保证的:把可能越界的问题识别出来,路由到正确的角色,而不是让模型自由发挥。
边界清晰的产品反而更容易做大。因为合作方——医院、保险、企业——最怕的不是能力弱,而是不可控。
三、循证知识库为什么是入场券
合规的本质是“可解释”。当监管、合作方或用户问“你凭什么这么建议”,答案不能是“模型算出来的”,必须是“依据是什么、证据等级如何、适用于谁”。
凯同AI的520万条循证知识库与5万+合规词库,解决的正是这个问题:每一条建议都能追溯到来源,每一个表述都在合规词库的约束内。这让内容审核从“逐条人工判断”变成“规则+抽检”。
循证知识库的价值不止于合规,它同时是方案质量的上限。没有证据支撑的建议,个性化程度越高,风险越大。
四、数据合规
食物数据库的准确性直接决定建议质量,数据来源、更新时间与误差范围都要可追溯。
具体落到三件事:采集时的目的说明、使用时的范围限制、共享时的授权链路。任何一项缺失,规模越大风险越高。
数据合规的难点在“二次使用”。用户授权了采集,不等于授权了训练、共享与商业分析,三者必须分开取得同意。
五、宣称与内容审核
涉及儿童与孕产妇时,监护人授权与专业审核缺一不可,不能仅靠通用模型输出。
内容审核要覆盖三个层面:对外宣传、产品内文案、模型生成的每一句答复。前两个可以靠流程,第三个必须靠规则拦截与抽检回流。
内容审核不能只审对外宣传。产品内的每一句提示、模型的每一次生成,都是对外表述,都在监管视野内。
六、凯同的做法
凯同在日常营养干预的合规设计分三层:模型层做意图识别与风险拦截,知识层做证据约束,运营层做抽检与复盘。三层之间互相校验,任何一层发现问题都能回溯。
《中国居民膳食指南》长期提示我国居民膳食结构存在油盐偏高、全谷物与蔬果摄入不足的问题,这是营养干预的基本出发点。
凯同把合规做成三层结构,是为了让审核可规模化:规则拦截大部分,人工处理边缘,抽检发现系统性偏差。
七、合规不是成本,是壁垒
短期看,合规会拖慢迭代速度;长期看,它是唯一能穿越监管周期的能力。当渠道、医院、保险与企业在选择合作方时,“能不能合规交付”往往是一票否决项。
这也是日常营养干预这个赛道的特点:跑得快的团队很多,能跑得久的很少。决定跑多久的,不是模型,而是底线。
在日常营养干预,合规能力会逐渐从成本项变成资质项。没有它,连参与竞争的资格都没有。
免责声明:本文为行业观察与信息交流,不构成医疗建议、诊断或治疗方案,也不构成投资建议。文中涉及的疾病、用药、检查与营养方案,请遵医嘱;如有不适或急症,请及时就医。文中数据与观点来自公开信息,仅供参考。